物理AI引领者论坛回顾|从世界模型到真实落地,物理AI的下一步怎么走?
8月19日,WRC 2026期间,由跨维智能主办的“物理AI引领者论坛”在北京举行。论坛设置五场主题演讲和一场圆桌对谈。
主题演讲环节,智象未来(HiDream.ai)创始人兼CEO、加拿大工程院外籍院士梅涛,大晓机器人董事长、商汤科技联合创始人王晓刚,跨维智能创始人兼CEO、香港中文大学(深圳)教授贾奎,清华大学计算机系副研究员苏航,以及香港中文大学(深圳)—深圳河套学院双聘助理教授、跨维智能科学家刘桂良,分别从世界模型、物理智能、规模化路径、基座模型和仿真数据等方向分享研究与实践。
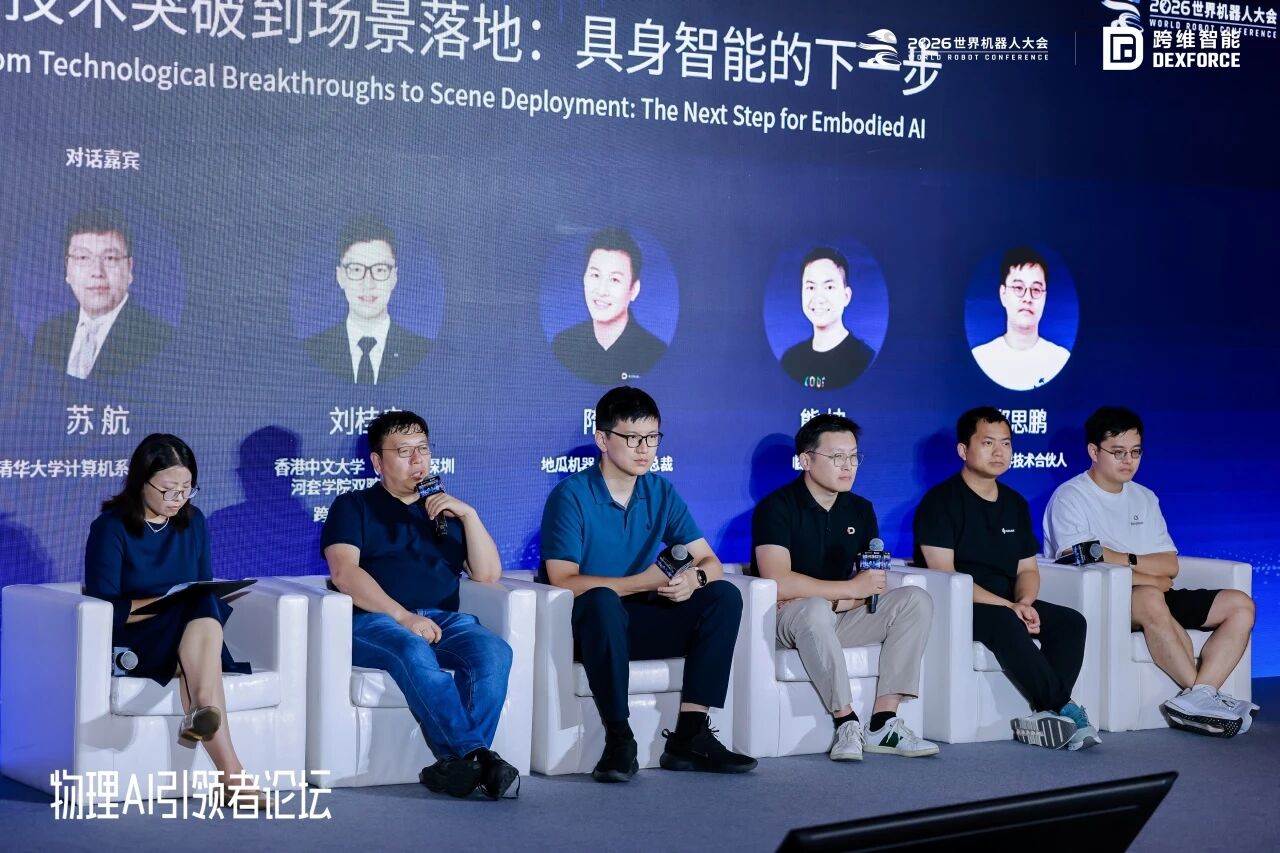
圆桌对谈由《财经》杂志副主编、资本证券板块负责人陆玲主持,苏航、刘桂良与地瓜机器人算法副总裁隋伟、临界点CTO熊坤、智在无界技术合伙人郑思鹏,共同讨论技术路线、数据来源、商业化落地及具身智能的“ChatGPT时刻”。
论坛吸引超200位来自学术界、产业界、投资机构及媒体的观众到场,全网直播及相关内容观看量近100万人次。论坛凝聚共识:物理AI不是单一模型的竞赛,而是数据、模型、仿真、硬件与真实部署协同推进的系统工程。
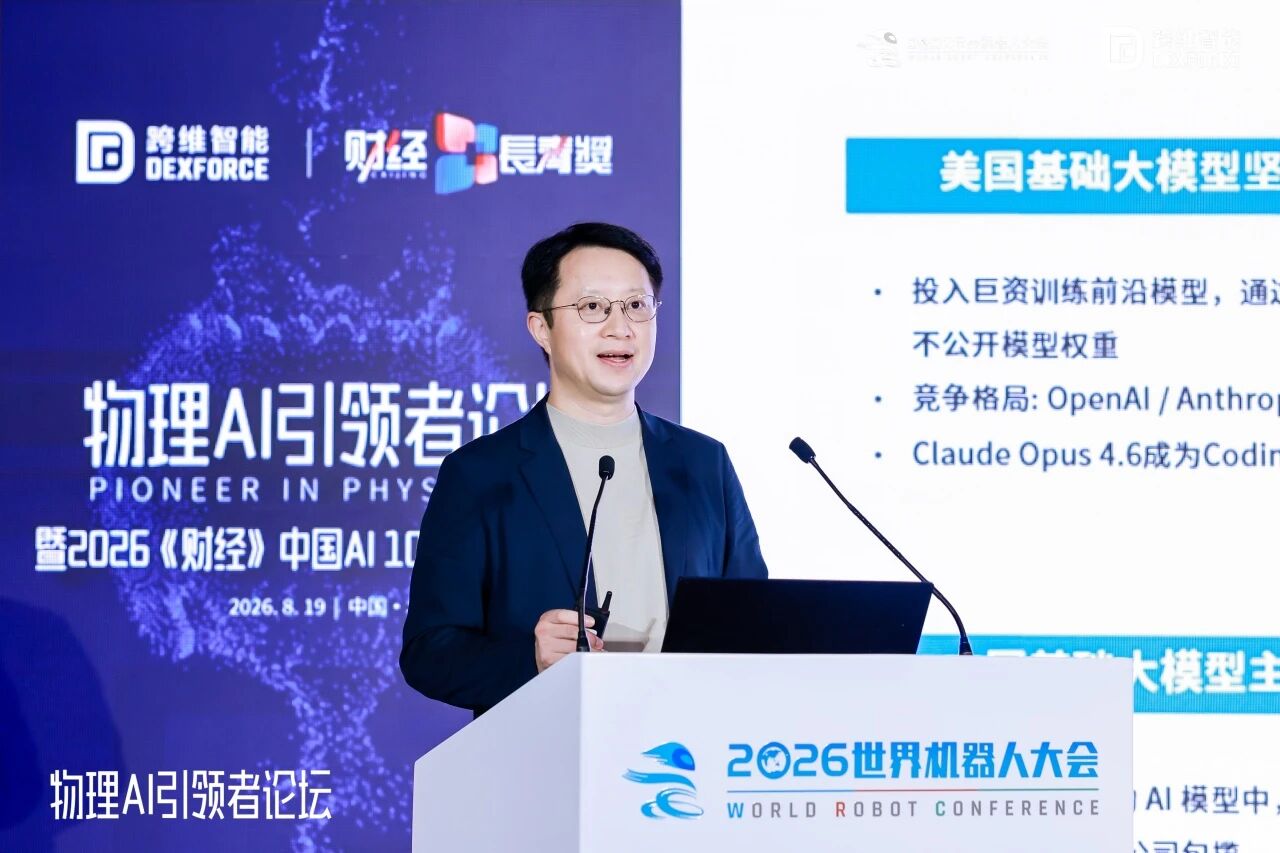
01 梅涛:原生全模态世界模型,从“模拟世界”到“交互世界”
智象未来(HiDream.ai)创始人兼 CEO、加拿大工程院外籍院士梅涛从“高 IQ 不等于会行动”切入:世界模型不仅要表达世界,还要推演状态变化、理解因果关系,并最终驱动智能体与具身本体采取行动,完成从认知到执行的闭环。
围绕这一目标,他重点介绍了以 Unified Transformer(UiT)为底座的原生全模态路线。UiT 试图在 Token 层面统一表达与对齐文本、图像、视频、3D、动作等不同模态,使世界模型从生成内容进一步走向模拟、理解、推演和交互,并为具身智能提供可用于训练与决策的世界认知基础。
谈到具身智能的能力底座,梅涛将关键关系概括为:“世界模型和具身智能的发展,需要把数据、世界模型、智能体和具身本体连接起来。”其中,数据构建认知,世界模型负责理解世界状态、推演物理规律,智能体基于预测结果进行决策和规划,具身本体完成真实执行,而真实环境反馈又回流成为新的训练数据。由此形成“数据—认知—行动—反馈”的闭环飞轮。梅涛表示,世界模型正是这一飞轮中的认知中枢;没有高质量世界模型,仿真难以逼近真实物理,具身智能的数据飞轮也难以真正转动起来。
02 王晓刚:物理智能的“开悟时刻”
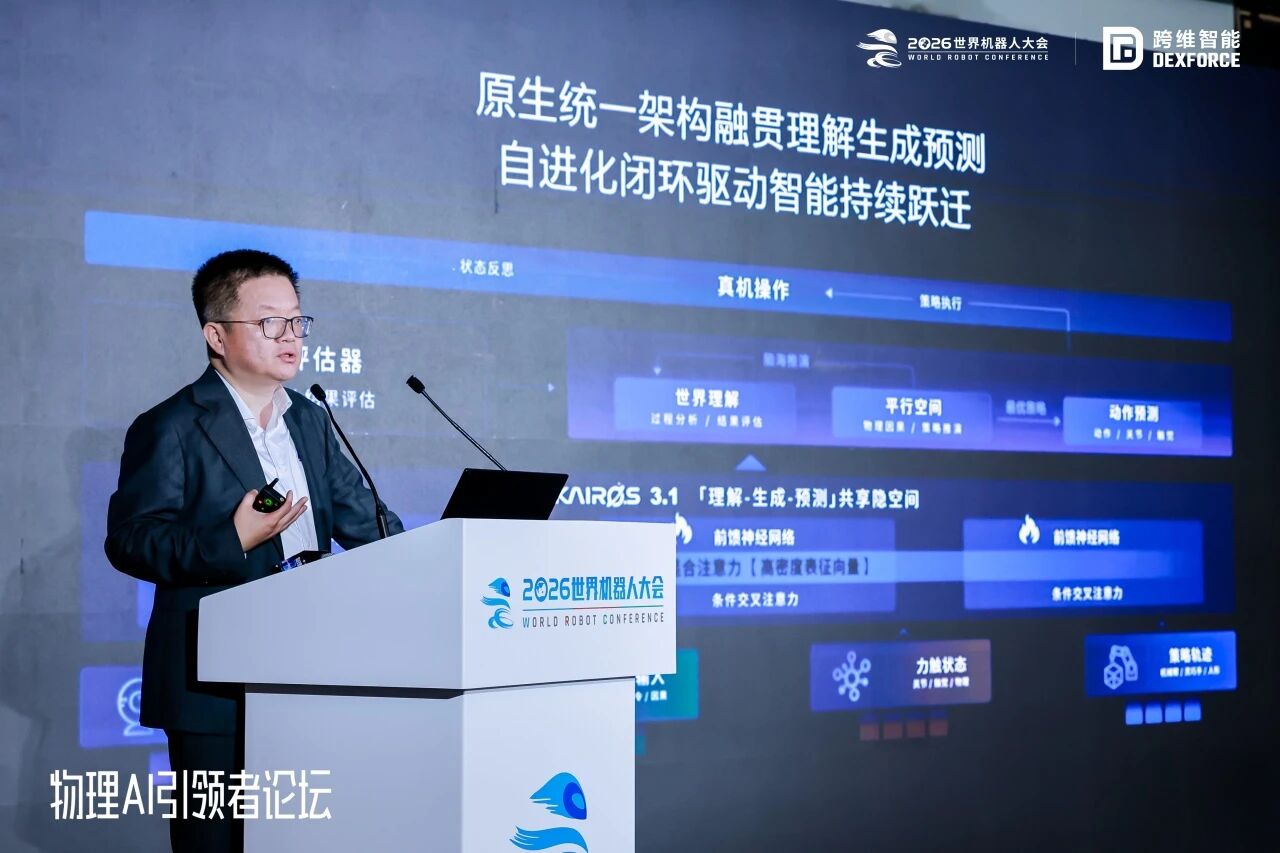
大晓机器人董事长、商汤科技联合创始人王晓刚所说的“开悟”,是让模型从现象进一步领悟背后的物理规律和因果逻辑,从而推动具身智能出现类似ChatGPT的能力跃迁。
围绕这一目标,大晓机器人提出“以人为中心”的环境式数据采集、世界模型及泛化具身模组的研发范式。在模型层面,“理解—生成—预测”一体化架构分别承担任务理解与分解、行动结果推演和真机控制。
王晓刚强调:“今天要让我们的世界模型同时具备这三种能力,才能够让机器人在物理世界当中进行复杂和准确的交互。”三种能力协同后,机器人才能在执行中判断成败、发现偏差,基于当前状态继续完成任务,而不是失败后从头再来。
03 贾奎:以Physical Token经济学,探索物理AI规模化路径
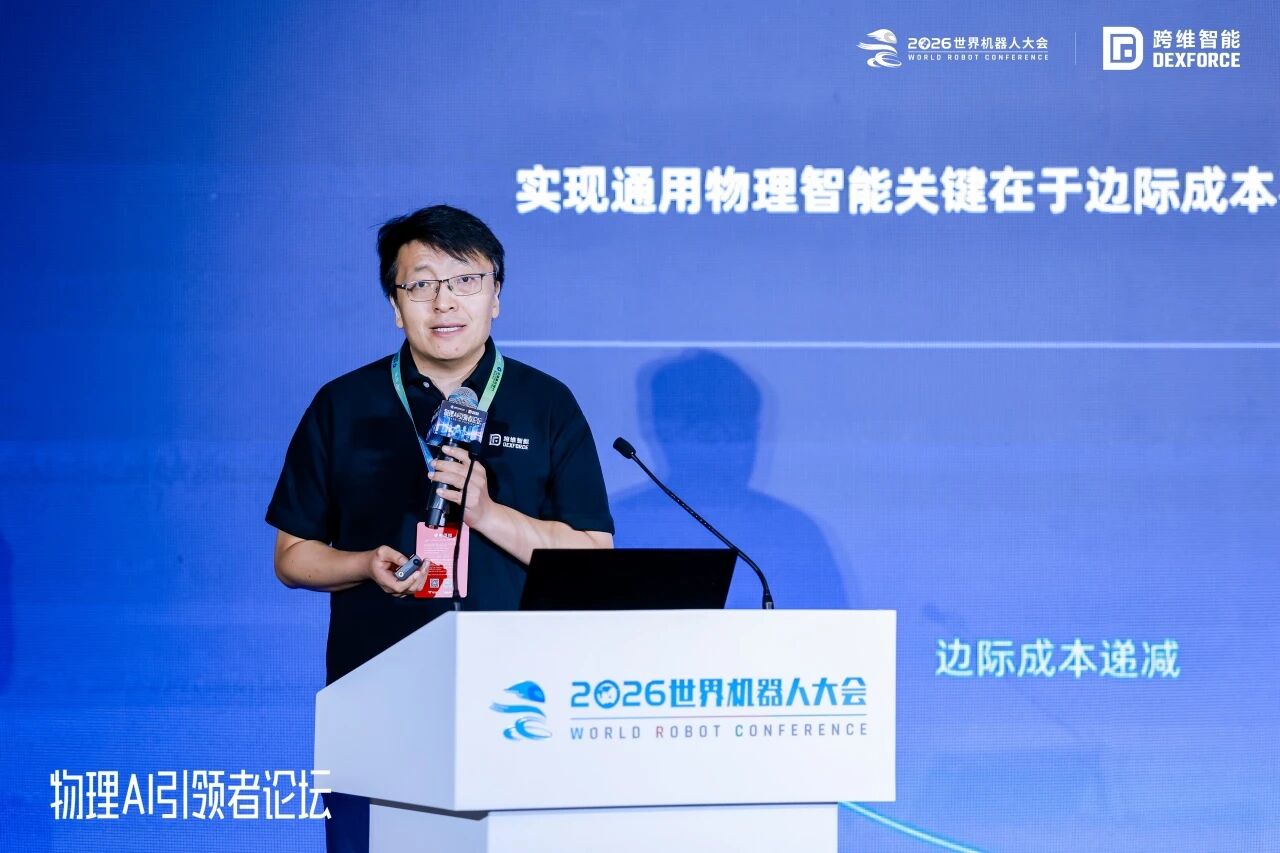
跨维智能创始人兼CEO贾奎以《Physical Token经济学》为题,从智能产出与成本重新审视物理AI规模化。他将Physical Token定义为“单位可靠物理智能”:不是单条数据或一次动作,而是人力、数据与算力投入后形成的可靠、可执行、可验证的任务能力。
贾奎指出,规模化不能只看机器人会多少技能,更要看获取下一项能力的边际成本。如果每进入新场景、适配新本体,都要重新采数、训练和调试,能力再多也只是项目复制;只有让已有经验、模型和部署反馈服务下一项能力,使新增投入持续下降,才可能形成规模经济,即“让下一份智能比上一份更便宜”。
为实现这一目标,贾奎提出“人类经验、合成杠杆、能力聚合、飞轮扩张”四个环节:统一数据表达,使经验跨任务、跨本体复用;以生成式仿真放大真实数据;通过后训练形成可靠技能;再让部署中的失败与长尾数据回流模型。四个环节形成闭环,推动物理AI从单点项目走向可复制、可持续的规模化落地。
04 刘桂良:仿真合成数据能否补上具身智能的数据缺口
香港中文大学(深圳)—深圳河套学院双聘助理教授、跨维智能科学家刘桂良将讨论落到具身智能的数据供给问题。与大模型可以从互联网中发掘海量数据不同,他指出:“到了具身智能时代,我们发现这个金矿并不存在,我们需要自己去造金子出来,造一些高质量的数据。”
真机数据生产流程长、人工投入高,也难以覆盖物体、任务、环境和本体的复杂变化;仿真数据则具备可规模扩展、可编辑和可自动标注等优势。
刘桂良进一步介绍了由生成式仿真、技能学习与数据标注组成的合成数据管线,并以深圳河套学院(SLAI)、跨维智能牵头主办的全球首个合成数据驱动真机挑战赛——RoboSynChallenge为例,探讨如何在少量真实数据的条件下生成可编辑的仿真环境,自动扩展任务和轨迹,再将训练结果部署到真机验证,用低成本合成经验补足真实世界的长尾状态。
05 苏航:从数字世界走向物理世界,关键在闭环
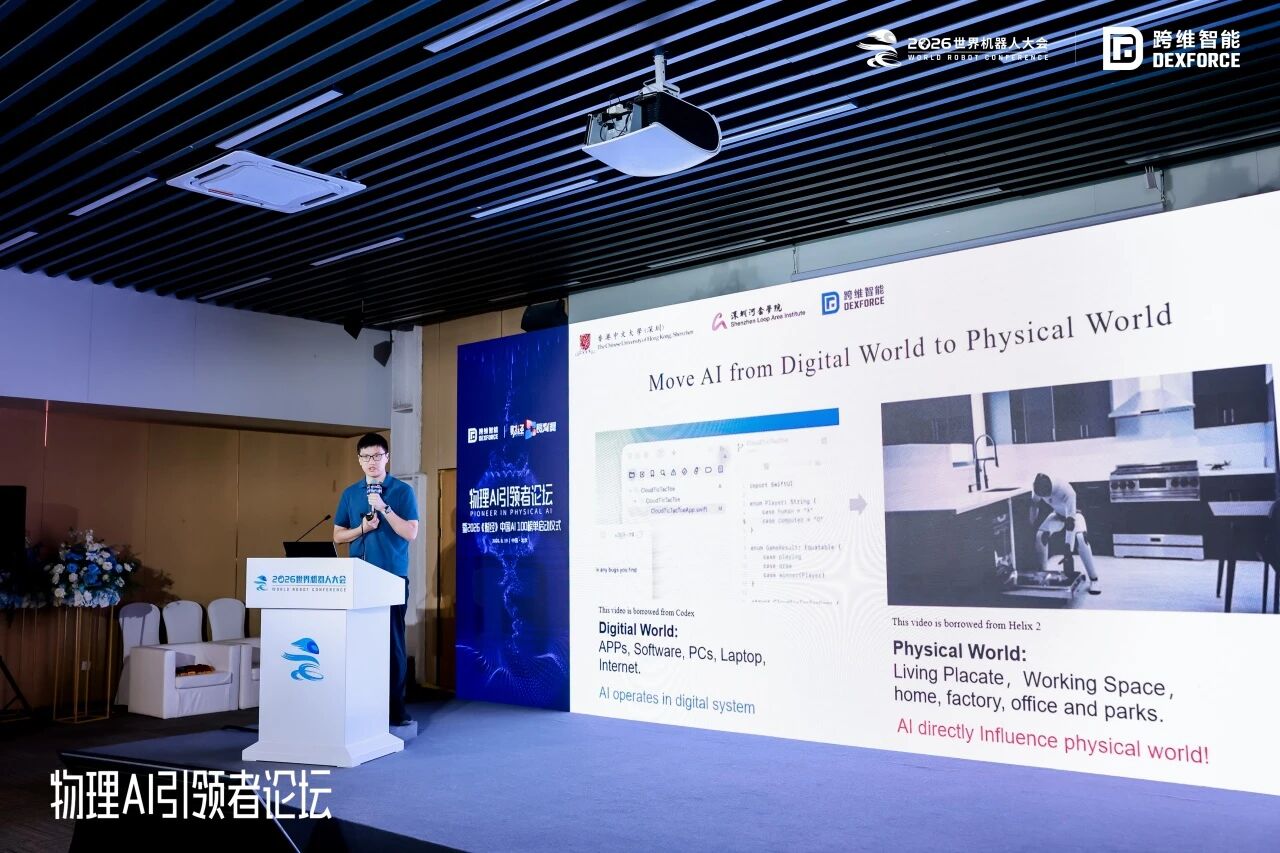
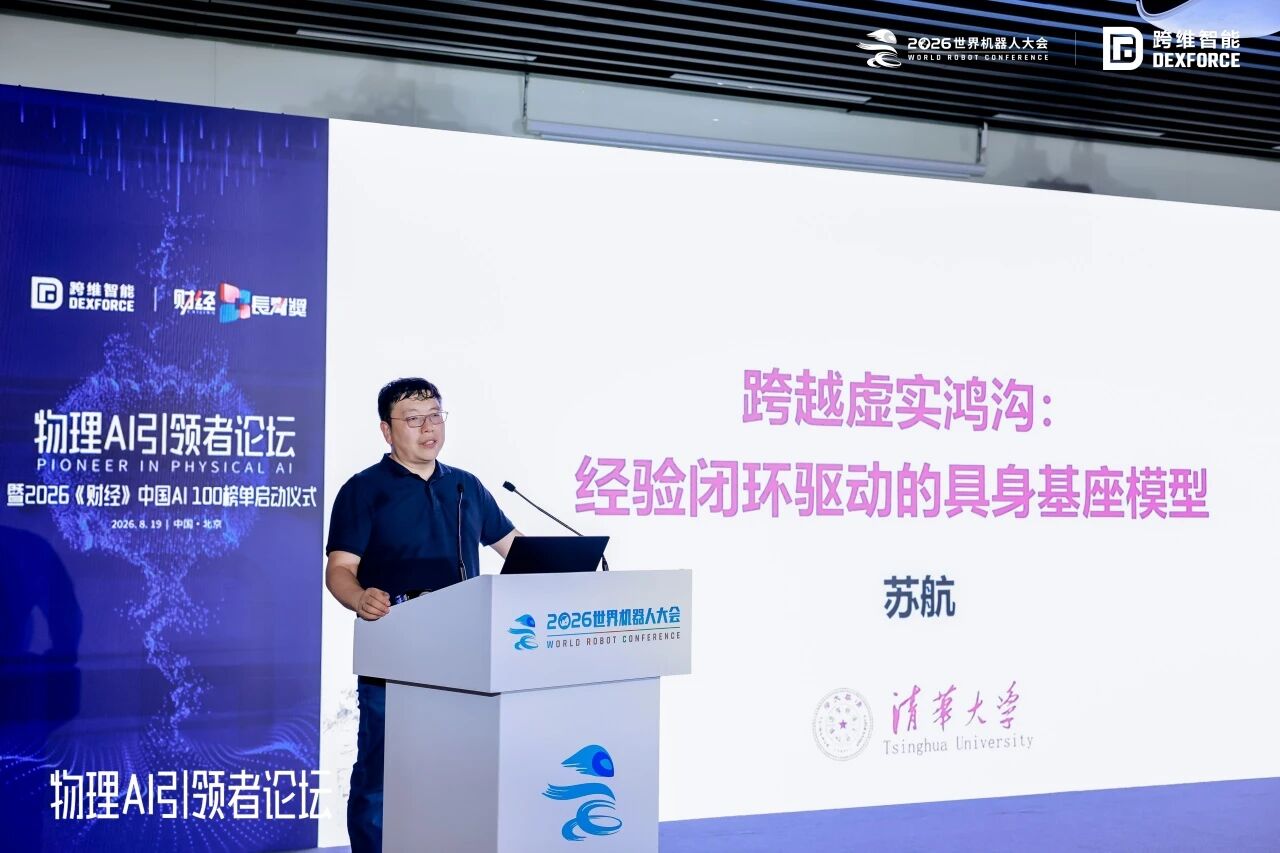
清华大学计算机系副研究员苏航讨论了基座模型如何从数字世界进入真实物理环境。他指出,物理世界中的智能体不仅需要理解语义,还要面对感知误差、动作偏差、接触变化和动态环境,模型能力最终必须在真实交互中接受检验和修正。
因此,具身智能的数据不能只追求数量,更需要质量、多样性与反馈闭环。机器人执行产生的结果反馈、失败轨迹和人工接管,都是模型继续学习的重要信号;尤其是接近失败但仍可恢复的中间状态,能够帮助模型理解何时可能出错、如何从偏差中恢复。
苏航指出:“能否建立高质量的真实世界数据闭环,并让模型持续从交互结果中学习,将成为推动具身智能从‘完成任务’走向‘适应环境’的重要基础。”
06 圆桌对谈:从技术突破到场景落地,具身智能的下一步
1、技术路线会收敛吗?
“VLA和世界模型并不是二选一的关系。”苏航认为,VLA擅长建立感知、语言与动作之间的映射,世界模型更关注环境变化和行动结果,未来更可能在不同时间尺度上形成融合。
郑思鹏则提醒,画面看起来合理,不代表三维关系一定准确;显式与隐式世界模型没有简单的优劣之分。刘桂良从仿真路线补充,面对数据规模的瓶颈,合成和扩增将是行业必须经历的阶段。
2、数据是一座矿,也是一笔账
郑思鹏将人类视频比作“一座丰富的宝矿”:场景、任务和轨迹足够多样,但要经过复杂的数据清洗和提炼,才能成为可用于预训练的高质量数据。
刘桂良更强调仿真的可扩展、可编辑与可复用;熊坤则把视线投向训练边界:“很多失败的数据,对于模型、对于后面的训练效果是最有用的。”
隋伟补充:“数据的使用效率,要同时看采集效率和训练效率。”其团队测试显示,生成式仿真可视任务节省约70%—90%的真实数据。
不同路线的共同问题,是新增数据能否真正转化为能力,而不只是增加数据量。
3、从Demo到量产,最难的是什么?
隋伟的判断很直接:“从实验室到最终量产,后面80%到90%的工作都是工程迭代。”真实环境中的稳定性、失败数据回流和端侧算力,都会把实验室能力重新检验一遍。
苏航提出,商业落地要看一次部署之后,后续相似场景的适配成本能否下降;刘桂良判断,工业等相对可控的环境更可能率先规模化。
熊坤则强调,灵巧手作为机器人与物理世界接触最频繁的末端,质量、稳定性和触觉能力缺一不可。
4、“ChatGPT时刻”还有多远?
嘉宾们没有给出统一时间表。
苏航把它理解为泛化能力的显著跃迁:机器人面对新环境、新物品和新任务时,能够复用已有能力,而不是重新采数和训练。刘桂良和隋伟认为,拐点取决于数据生产和预训练范式何时收敛;熊坤提醒,硬件与触觉能力同样决定系统上限;郑思鹏则用“木桶效应”概括这项系统工程——基础模型、仿真、后训练、端侧部署和硬件必须共同成熟。
不同答案背后,圆桌形成共识:具身智能的拐点不会由某一项技术单独定义,而要等数据、模型、硬件与工程能力共同跨过可靠性与成本的门槛。
论坛没有划定唯一方向,却让物理AI的演进路径更加清晰:真实数据、生成式仿真、模型训练与部署反馈正逐步形成闭环。未来的竞争,不只是单点能力的比拼,更在于谁能让这套闭环持续运转,以更低成本生产和复制可靠的物理智能。